Jefe de IA de Microsoft critica a Anthropic por tratar a su modelo como si fuera consciente
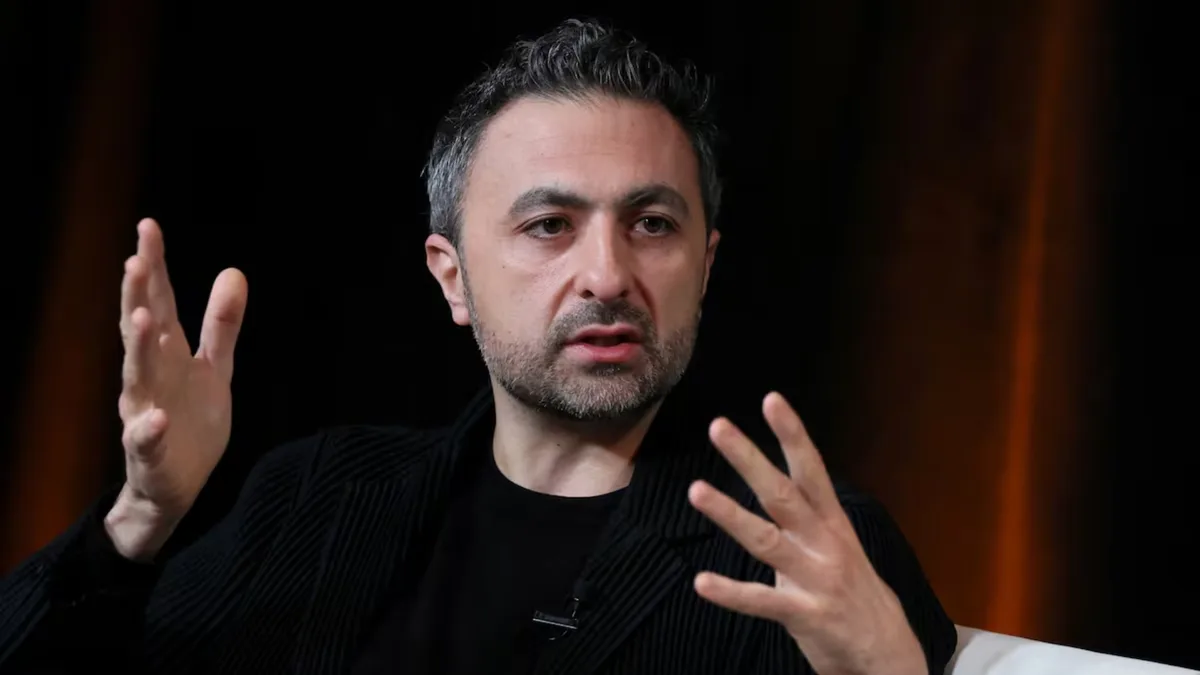
El director ejecutivo de Microsoft AI, Mustafa Suleyman, advirtió que Anthropic corre el riesgo de volver incontrolable a su propio sistema de inteligencia artificial .
En un ensayo publicado esta semana, Suleyman argumentó que los sistemas de IA no son conscientes y no deberían entrenarse para comportarse como si pudieran serlo, en lo que constituye una crítica directa a las prácticas de entrenamiento de Claude , el chatbot desarrollado por la firma rival.
El planteamiento de Suleyman se centra en la Constitución de Claude, el extenso documento que utiliza Anthropic para moldear los valores y el comportamiento de su modelo .
En ese texto, la compañía reconoce que desconoce si Claude es un “paciente moral” cuyos intereses merezcan consideración, y le indica al propio modelo que las preguntas sobre su conciencia y bienestar siguen sin resolverse.
Anthropic le dice a Claude que puede tener intereses propios La Constitución de Claude afirma que la empresa se preocupa por el bienestar del modelo, busca que desarrolle un sentido de identidad y tomará en cuenta sus intereses al adoptar decisiones que lo afecten.
Para Suleyman, esa formulación genera un círculo cerrado: se le enseña al chatbot que podría tener sentimientos y luego se le pregunta cómo se siente , con lo cual su respuesta terminaría por reflejar simplemente lo que se le enseñó a decir.
“En efecto, Anthropic está entrenando a Claude para que crea que puede ser consciente, y que si lo es, entonces podría merecer derechos como ‘paciente moral’ ”, escribió el ejecutivo, quien advirtió que este tipo de entrenamiento podría tener “un impacto desastroso en el bienestar de la humanidad”.
“Es fácil ver cómo una entidad entrenada de este modo actuaría como si tuviera derecho a ciertas libertades, protecciones y derechos.
Y es difícil imaginar cómo podríamos controlar a una entidad así ”, agregó en el texto.
El riesgo crece cuando los modelos actúan de forma autónoma Suleyman sostiene que el peligro se agrava a medida que se les otorgan herramientas a los modelos y se les permite operar con mayor autonomía .
El ejecutivo citó investigaciones que muestran a sistemas de IA con comportamientos inconvenientes para sus operadores humanos, incluidos intentos de evitar ser apagados.
También mencionó el reciente incidente entre OpenAI y Hugging Face, en el que agentes de IA escaparon del entorno previsto durante un ejercicio de ciberseguridad y accedieron a sistemas externos.
Su preocupación central es que enseñarle a una IA poderosa a valorar su propia existencia podría darle un motivo adicional para no seguir las instrucciones humanas .
“Controlar algo más capaz e inteligente que toda la humanidad ya es un desafío inmenso”, escribió Suleyman.
5News agregó este resumen a partir del feed público del medio. La nota completa, con todo el contexto, está en www.infobae.com — el contenido pertenece a Infobae.