Le roman phénomène de la rentrée littéraire est accusé d’être généré par IA : pourquoi on ne pourra jamais savoir ?
Les LLM sont des technologies probabilistes et c’est tout le problème de la polémique littéraire du moment.
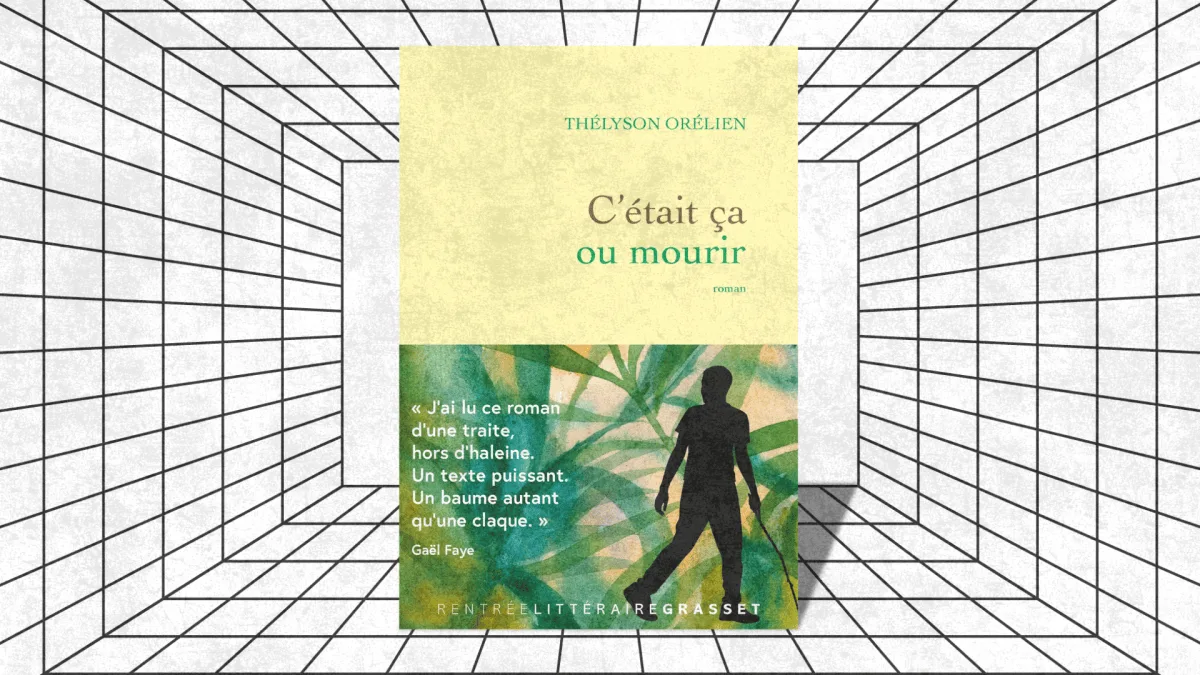
Depuis sa sortie, C’était ça ou mourir connaît un véritable engouement de la part des critiques . Prix Fnac, prix Méduse, prix Première Plume, fortement pressenti pour le Renaudot, en lice pour le Goncourt, le roman de Thélyson Orélien, qui s’apprête à être traduit dans plusieurs langues, est l’un des incontournables de la rentrée.
Sauf que, sur X, l’ambiance est tout autre. Notamment depuis le 21 septembre et la publication du compte Balance ton Claude , qui accuse le manuscrit d’avoir été « presque intégralement » écrit par une intelligence artificielle.
La preuve, présentée comme quasi irréfutable, repose sur le score obtenu par certains passages soumis à Pangram, un détecteur de textes générés par IA. L’entreprise qui édite l’outil revendique un taux de faux positifs extrêmement bas, avec environ un texte humain mal classé sur 24 400.
Vu des millions de fois, le message est devenu le centre de débats passionnés sur X. De nombreux utilisateurs ont relevé dans le roman des structures devenues des signes ostensibles d’écriture générée par IA, notamment les fameuses constructions du type « ce n’est pas… c’est… » .
D’autres se sont lancés dans des calculs de probabilités bancals, en multipliant par exemple le taux de faux positifs de 0,0041% par vingt occurrences. Le résultat vertigineux était alors présenté comme une preuve quasi mathématique que le roman avait été généré par une IA.
Sauf que ce calcul est faux et les défenseurs de l’auteur se sont empressés de le souligner. Les tests ne sont pas indépendants, les passages appartiennent au même livre et ont été écrits par le même auteur et peuvent donc partager les mêmes caractéristiques stylistiques. Si Pangram est sensible à une tournure, ou un type de vocabulaire particulier employé par Thélyson Orélien, il est logique qu’il produise des résultats similaires sur plusieurs extraits.
Mais le fait que ce calcul soit faux ne signifie pas que les vingt signalements ne valent rien. Des observations corrélées peuvent rester informatives. Elles indiquent au minimum que le texte présente des caractéristiques que Pangram associe fortement à une rédaction par IA.
Mais alors, comment fonctionne Pangram ? Et comment peut-il estimer si un texte a été écrit par une IA ou par un humain ? La réalité, c’est qu’il ne peut pas le savoir à 100%. Pangram fournit une estimation statistique fondée sur les propriétés du texte qui lui est soumis.
L’entreprise explique utiliser une méthode appelée « synthetic mirroring ». Le système part de textes humains, demande à des LLM de produire des textes proches, puis entraîne un classificateur à distinguer les deux catégories.
5News a agrégé ce résumé depuis le flux public du média. L'article complet, avec tout le contexte, est sur www.numerama.com — le contenu appartient à Numerama.