NVIDIAが画像・動画・文章をまとめて理解するオープンウェイトAI「Nemotron 3.5 Super VL」を公開、処理コストを40分の1に削減する事例も
親愛なる読者の皆さまへ。ご存じの通り価格高騰などの悪影響でサーバー運営がとても苦しい状態です。回線や台数を整理し見直せる部分は全て見直しましたが、やはりまだ危険水域です。このままだと1ページを10分割ぐらいして無理矢理PVを増やさざるを得なくなってしまいます。そこで、GIGAZINEの物理的なサーバーたちを、たった1円でも良いので親愛なる読者の皆さまに支援してもらえればとっても助かります!今すぐ寄付は上のボタンから! ・ これまでGIGAZINEを支援してくれたメンバーのリスト
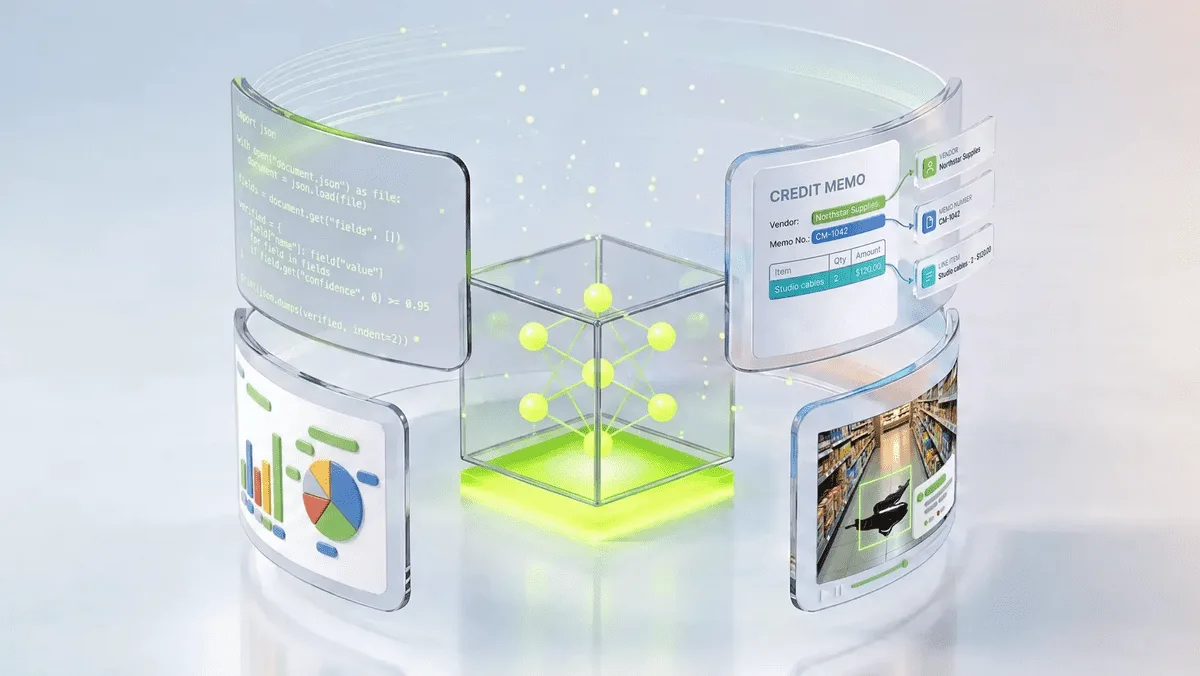
NVIDIAが2026年10月15日に文章や画像、動画をまとめて理解できるオープンウェイトAIモデル「NVIDIA Nemotron 3.5 Super VL」を公開しました。複数の情報を組み合わせて作業を進めるAIエージェント向けのモデルで、同規模のオープンモデルと比較して最大5倍の処理能力を発揮するとのこと。企業の業務に合わせて調整したモデルではAIの処理コストを40分の1に削減した事例も報告されています。 NVIDIA Nemotron 3.5 Super VL Powers Specialized Agents with Multimodal Reasoning | NVIDIA Technical Blog https://developer.nvidia.com/blog/nvidia-nemotron-3-5-super-vl-powers-specialized-agents-with-multimodal-reasoning/ AIを使って仕事を自動化する場合、文章を読み取るだけでは作業が完結しないことがあります。NVIDIAが公開したNemotron 3.5 Super VLは文章の理解や推論、画像・動画の解析、外部ツールの操作を1つのモデルで扱えるようにしたもの。既存の「Nemotron 3 Super」から画像や動画を扱う能力を拡張し、複雑な作業を進める能力も強化しています。 NVIDIAが1200億パラメータ規模の日本語対応ハイブリッドMoEオープンウェイトAIモデル「Nemotron 3 Super」を発表 - GIGAZINE
Nemotron 3.5 Super VLは1200億個のパラメータを持つ大規模なAIモデルですが、必要な部分だけを動かす「Mixture of Experts(MoE)」という仕組みによって1トークンを処理する際に使うパラメータは120億個に抑えられています。 以下のグラフはAIモデルの性能を示す「Intelligence Index」と文章の生成速度を比較したもの。縦軸が性能、横軸が1秒間に生成できるトークンの数を表しており、Nemotron 3.5 Super VLは毎秒600トークン以上を記録しています。同規模のオープンモデルと比較して単一のGPUでAIエージェントの処理を行う際のスループットが最大5倍に達するとのこと。
また、以下のグラフはNVIDIA B200 GPUを4基使って1万件のソフトウェア開発タスクを処理した場合の所要時間と正確性を比較したもの。Nemotron 3.5 Super VLは約10時間で1万件の処理を完了し、正確性は約51%となっています。Nemotron 3.5 Super VLは他の同規模モデルと比べて最大4倍の速さで作業を完了しました。
画像や動画を理解する能力も強化されており、グラフの読み取り能力を評価する「CharXiv」では80.8%のスコアを記録しました。NVIDIAの別モデル「Nemotron 3 Nano Omni」の63%を上回っており、Pythonを使ってグラフを分析する条件では84%に達しています。 さらに、企業が自社の業務に合わせてモデルを追加学習させることも可能です。NVIDIAはAIモデルの学習・調整用ソフトウェア「NVIDIA NeMo」を提供しており、企業独自の文書や業務手順、社内規則などに合わせてNemotron 3.5 Super VLを調整できます。
実際にAI開発企業のScale AIはエンターテインメント企業のSkydance Corporation向けに、取引先からの請求書や返金・値引きに関する書類を確認し、未回収の金額を調べる業務を自動化するモデルを開発しました。実際の業務データを使ったテストでは、追加学習後のモデルはSkydanceが運用中のAIと同程度の正確性を示しながら処理コストを約40分の1、応答時間を約5分の1に削減できたとのこと。 経費管理サービスを手がけるRampはレシート画像から店舗名や日付、支払い情報などを抽出する業務に活用しています。Rampは処理能力が最大50%向上し、処理の待ち時間が10分の1になると見込んでいます。さらにAI21とAliceがサイバーセキュリティ分野の脅威分析向けに調整したモデルでは、正確性が41ポイント向上したと報告されています。 以下のグラフは企業ごとの業務で追加学習前後のNemotron 3.5 Super VLの正確性を比較したもの。薄い緑色が追加学習前の正確性、濃い緑色が追加学習による改善幅を表しており、企業の業務に合わせた調整によって正確性が向上していることが分かります。
Nemotron 3.5 Super VLではAIの運用コストを抑えるため、文章を生成する際に複数の単語の候補を先読みする技術「LiLiCorr」が採用されており、NVIDIAの小型AIコンピューター「DGX Spark」では先読みを使わない場合と比べて文章の生成速度が最大2.3倍になるとのこと。また、AIエージェントが同じ指示や会話履歴を繰り返し読み込む際には以前の計算結果を再利用する仕組みも備えています。 多数のユーザーが同時にAIを利用する環境では、AIの処理を効率的に振り分けるソフトウェア「NVIDIA Dynamo」も利用できます。NVIDIA B200 GPUを16基使用したテストでは、1人当たりの文章生成速度を維持しながら対応できるユーザー数が最大8倍になり、回答の生成が始まるまでの待ち時間も85%短縮されたとのこと。
Nemotron 3.5 Super VLはモデルの重みがHugging Faceで公開されており、商用利用や追加学習にも対応しています。学習用データや開発者向けの資料なども公開されており、企業や開発者は用途に合わせてモデルを調整できるとのことです。 nvidia/NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-NVFP4 · Hugging Face https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-NVFP4
・関連記事 ハードウェアに合わせて自動最適化してオープンモデルを最大2倍高速化するAIエージェント向け推論エンジン「Magnitude」、Appleシリコン・NVIDIA・AMD・CPUに対応 - GIGAZINE NVIDIAがアメリカ最強オープンモデル「Nemotron 3 Ultra」を発表&AIサーバー「Vera Rubin」の量産開始を報告 - GIGAZINE NVIDIAがAIエージェント向け高速モデル「Nemotron 3.5 Lightning」を公開、最適なAIモデルを選ぶ「NeMo Switchyard」も登場 - GIGAZINE NVIDIAが大手顧客に対してAI関連製品を15%以上値上げすると通知、「Vera Rubin」や「Grace Blackw
この要約はメディアの公開フィードから5Newsが集約したものです。 文脈も含めた全文はgigazine.netにあります — コンテンツの権利はGIGAZINEに帰属します。