NVIDIAがAIエージェントによるタスクをローカルで実行するための「Nemotron 3.5 Bolt 74B-A9B 24GB」を発表
親愛なる読者の皆さまへ。ご存じの通り価格高騰などの悪影響でサーバー運営がとても苦しい状態です。回線や台数を整理し見直せる部分は全て見直しましたが、やはりまだ危険水域です。このままだと1ページを10分割ぐらいして無理矢理PVを増やさざるを得なくなってしまいます。そこで、GIGAZINEの物理的なサーバーたちを、たった1円でも良いので親愛なる読者の皆さまに支援してもらえればとっても助かります!今すぐ寄付は上のボタンから! ・ これまでGIGAZINEを支援してくれたメンバーのリスト
現地時間の2026年10月15日、NVIDIAが日常的なAIエージェントのタスクをローカルで実行するために設計された「 Nemotron 3.5 Bolt 74B-A9B 24GB 」を公開しました。 MoE を採用し、 Mamba と Transformer という2つのモデル構造を組み合わせたAIモデルとなっており、ローカルで実行しながら他のアプリケーションを同時に動作させることができるほど軽量です。 NVIDIA Nemotron 3.5 Bolt 74B-A9B 24GB - NVIDIA Nemotron https://research.nvidia.com/labs/nemotron/Nemotron-3.5-Bolt-24GB/
「Nemotron 3.5 Bolt 74B-A9B 24GB」は毎秒80トークン以上のデコード速度を達成しながら、能力を最大限に高めるよう設計されたAIモデルです。より大規模な「Nemotron 3.5 Super VL」に、モデル構造を整理・削減する「構造化圧縮」を適用し、さらにネットワークを2ビットへと大幅に量子化することで、一から学習させて4ビットに量子化した同程度のサイズのAIモデルを上回る性能が得られることを示したAIモデルであるとNVIDIAは説明しています。 NVIDIAによると、同等サイズの場合、小規模なAIモデルを一からトレーニングして構築するよりも、大規模なAIモデルを圧縮して小規模モデルを構築する方が、パフォーマンスが優れたものになることが証明されているそうです。 圧縮には「 Star Elastic 」と呼ばれる手法が使用されており、総パラメーター数が1200億・推論時の有効パラメーター数が120億の親モデルを、総パラメーター数740億・推論時の有効パラメーター数90億へと圧縮しています。圧縮後、追加の 事後学習 を行うことで、AIモデルの能力を可能な限り底上げしているそうです。 MoEの専門家ネットワークを「IQ2_XXS」という量子化形式で、1要素当たり2.0625ビットにまで圧縮。また、量子化を考慮して教師モデルから学習する 量子化対応蒸留 (QAD)を用いることで、精度を回復させています。 「Nemotron 3.5 Bolt 74B-A9B 24GB」では出力候補を先に生成し、本体モデルがまとめて検証する投機的デコーディングを高速化するため、候補生成モデルの「 LiLiCorr 」を採用しています。DSparkやDFlash2といった類似手法と比べて、候補の採用率を高め、遅延を削減することに成功しています。 RTX Spark 上で「Nemotron 3.5 Bolt 74B-A9B 24GB」を実行した場合のパフォーマンスをまとめたグラフが以下。AIモデルのトークン生成速度を評価するベンチマークであるSPEED-Benchが横軸で、AIモデルが経済的に価値のある現実世界の知的労働をどれだけ正確に遂行できるかを評価するベンチマークのGDPVal v2が縦軸です。
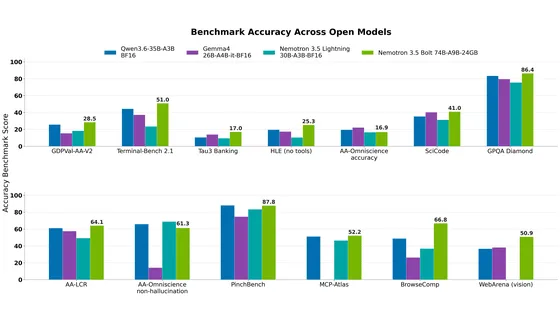
以下のグラフは、「Nemotron 3.5 Bolt 74B-A9B 24GB」とオープンなMoEモデルのベンチマークスコアを比較したもの。実施されたベンチマークはAIの実務遂行能力を測定するGDPVal-AA-V2、コマンド操作で作業を完遂する能力を測定するTerminal-Bench 2.1、銀行業務における顧客対応能力を測定するTau3 Banking、幅広い学問分野の超難問をツールなしの自力で解く能力を測定するHLE(no tools)、幅広い分野の知識の正確さを測定するAA-Omniscience accuracy、科学研究に必要なプログラムを書く能力を測定するSciCode、大学院レベルの科学知識と推論能力を測定するGPQA Diamond、長い資料を読み情報を組み合わせて思考しながら無理な回答を行わないかを測定するAA-LCR、知らないことをでたらめに答えない能力を測定するAA-Omniscience non-hallucination、AIエージェント基盤であるOpenClaw上での実用的な作業能力を測定するPinchBench、外部ツールを組み合わせて使う能力を測定するMCP-Atlas、ウェブ上で見つけにくい情報を探し出す能力を測定するBrowseComp、ウェブ画面を見て操作する能力を測定するWebArena(vision)です。
NVIDIAのRTX Spark関連情報を伝える公式XアカウントのNVIDIA RTX Sparkは、「NVIDIA Nemotron 3.5 Bolt 24GBは、手元のデバイスで動作する強力なAIエージェントを身近にしてくれます。総パラメーター数740億、推論時の有効パラメーター数90億のAIモデルで、24GBのメモリに収めることが可能です。他のアプリと同時に動作しながら、賢さと処理速度を両立します。NVIDIAの小型AIコンピューターである『RTX Spark』向けに最適化されており、次のプロジェクトですぐに活用できます」と紹介しています。
NVIDIA Nemotron 3.5 Bolt 24GB puts powerful local agents within reach. ⚡ 74B-A9B parameters packed into 24GB of memory, balancing intelligence and speed while running alongside your apps. Optimized for RTX Spark and ready for your next project. pic.twitter.com/wzbu8aN8ln
NVIDIAのAI関連情報を伝える公式XアカウントのNVIDIA AIは、「このモデルは24GBのメモリに収まります」とサイズのコンパクトさを強調しました。
And this one fits into 24GB of memory.
この要約はメディアの公開フィードから5Newsが集約したものです。 文脈も含めた全文はgigazine.netにあります — コンテンツの権利はGIGAZINEに帰属します。