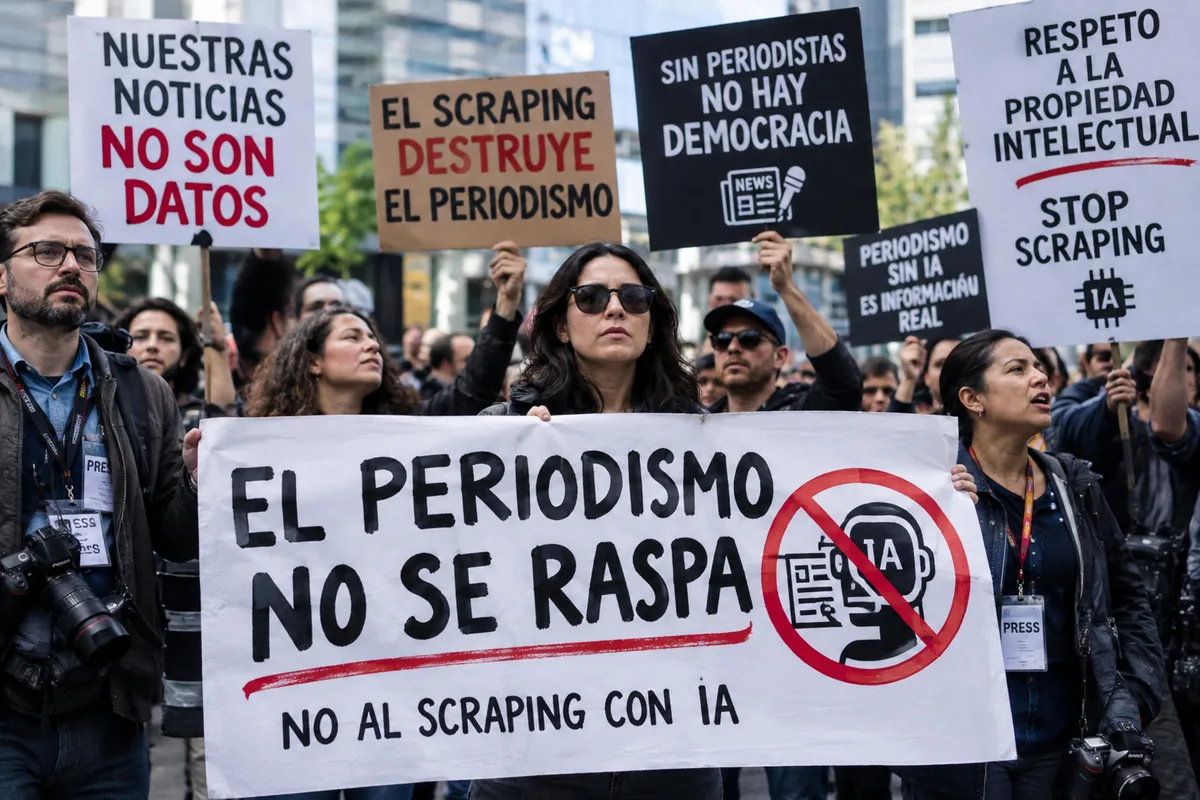
La revuelta de los periodistas contra el ‘scraping’ con IA
Por Agustino Fontevecchia, Project Syndicate.
BUENOS AIRES- En tan solo unos pocos años, herramientas de IA como ChatGPT y Claude se han convertido en una tecnología generalizada.
Las empresas que están detrás de estos productos innovadores alaban sus inmensos beneficios potenciales para la humanidad.
Pero este discurso, aunque no es necesariamente erróneo, pasa por alto que estos modelos se basan en el robo generalizado de obras protegidas por derechos de autor y amenazan con debilitar aún más un pilar de la democracia ya de por sí frágil: el periodismo.
Por eso, Editorial Perfil, una importante editorial latinoamericana con sede en Argentina (y propietaria de Perfil, el periódico en el que soy director digital), ha demandado recientemente a OpenAI, propietaria de ChatGPT, y a Microsoft, el mayor accionista externo de la empresa, por el uso indebido del contenido periodístico de Editorial Perfil en sus productos de IA.
En la demanda por daños y perjuicios presentada ante el Tribunal Federal Civil y Comercial de Argentina, también hemos acusado a estas empresas de “competencia desleal”; en otras palabras, de abusar de su posición oligopolística en nuestro perjuicio.
Aunque Editorial Perfil es la primera editorial en lengua española en presentar una demanda por infracción de derechos de autor contra una empresa de IA, sigue los pasos de The New York Times, que demandó a OpenAI y a Microsoft por el mismo motivo a finales de 2023.
El periódico brasileño Folha de São Paulo presentó un caso similar en 2025, que finalmente culminó en un acuerdo de licencia de contenidos a principios de este año (un enfoque que OpenAI ha adoptado con otras editoriales, incluida PRISA, el conglomerado español propietario de El País).
Ya hemos pasado por esto antes: las plataformas dominantes de búsqueda y redes sociales también se beneficiaron de contenidos informativos protegidos por derechos de autor sin compartir siempre los beneficios.
Los motores de búsqueda, como el modelo “gratuito” de Google, hicieron que los artículos periodísticos fueran mucho más accesibles al incluirlos en sus páginas de resultados.
Pero, a pesar de depender en gran medida de este contenido protegido por derechos de autor para impulsar los ingresos publicitarios, Google no estaba obligado a proporcionar una compensación adecuada a las empresas de medios de comunicación que podrían emplear a cientos de periodistas para producirlo.
Es cierto que estos sistemas de distribución dirigían el tráfico hacia los sitios web de los editores, pero el terreno de juego nunca fue equitativo y se inclinó cada vez más a favor de las empresas tecnológicas a medida que estas consolidaban su poder.
5News agregó este resumen a partir del feed público del medio. La nota completa, con todo el contexto, está en vanguardia.com.mx — el contenido pertenece a Vanguardia (Coahuila).